Świat staje się coraz bardziej oparty na komunikacji, a sztuczna inteligencja generatywna (GenAI) pomaga ludziom odnaleźć się w coraz bardziej złożonym otoczeniu. W branży rozrywkowej widzowie telewizyjni korzystają z wyszukiwania głosowego, aby przebrnąć przez gąszcz treści wideo, który stale się rozrasta i ulega dalszej fragmentacji między różnymi kanałami i serwisami.
Pomimo powszechnego stosowania funkcji głosowych w różnych urządzeniach przydatność tej technologii zależy jednak od danych — rzeczywistych informacji w czasie rzeczywistym, które system LLM1 wykorzystuje do weryfikacji, uzupełniania i korygowania odpowiedzi udzielanych na zapytania użytkowników. W kontekście serwisów streamingowych ma to szczególne znaczenie w przypadku treści epizodycznych.
Nie tylko ilość treści seriali znacznie przewyższa liczbę dostępnych filmów, ale widzowie szukają odcinków seriali w inny sposób niż filmów. Widzowie rzadko znają konkretny sezon lub odcinek, który chcą obejrzeć, zwłaszcza w przypadku seriali emitowanych od dawna, takich jak „NCIS”, „Chirurdzy” czy „Simpsonowie”. Dlatego podczas wyszukiwania używają zapytań kontekstowych, np. „Pokaż mi świąteczne odcinki serialu »Biuro«”lub „W których odcinkach serialu »Przyjaciele« gościnnie występuje Bruce Willis?”.
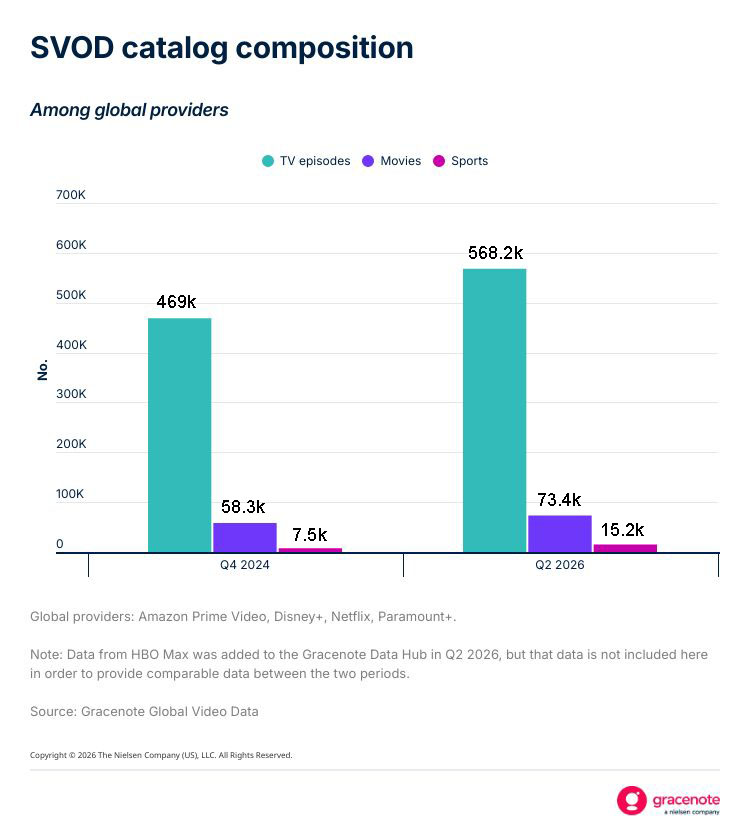
W takich przypadkach odpowiedzi serwisu LLM będą zazwyczaj błędne. Wynika to z faktu, że opierają one swoje odpowiedzi na prawdopodobieństwie, uwzględniając sezon i numer odcinka. Dla dostawców słaba jakość obsługi związana z błędnymi odpowiedziami potęguje frustrację wynikającą z rosnącej fragmentacji treści. Treści epizodyczne odgrywają dużą rolę w przeciążeniu treściami, ponieważ odcinki seriali telewizyjnych stanowią 85% treści dystrybuowanych przez sześciu globalnych dostawców usług SVOD uwzględnionych w Gracenote Data Hub.
Wraz z rozwojem katalogów filmowych i seriali sztuczna inteligencja generatywna (GenAI) będzie stawać się coraz bardziej pomocna dla widzów poszukujących treści do obejrzenia. Na przykład w ciągu zaledwie półtora roku liczba odcinków seriali dostępnych dla widzów wzrosła o ponad 21%.
Dzięki takim funkcjom, jak wyszukiwanie konwersacyjne, spersonalizowane grafiki programowe, dostosowane do potrzeb rekomendacje oraz najciekawsze fragmenty wydarzeń sportowych w czasie rzeczywistym, GenAI zrewolucjonizuje sposób, w jaki widzowie korzystają z treści wideo.
Aby zapewnić te możliwości — i dostarczać je w sposób dostosowany do potrzeb i spersonalizowany — duże modele językowe (LLM), które stanowią podstawę wyszukiwania i odkrywania treści, muszą mieć dostęp do dokładnych i wyczerpujących danych dotyczących rozrywki. Dotyczy to zwłaszcza 50% Amerykanów, którzy twierdzą, że rozważyliby rezygnację z usługi, gdyby nie zapewniała ona treści, któreich interesują².
Dostęp do zweryfikowanych danych w czasie rzeczywistym ma kluczowe znaczenie, ponieważ modele LLM wdrażane do użytku korporacyjnego nie są powiązane z żadnymi zewnętrznymi źródłami informacji. W odróżnieniu od popularnych chatbotów (np. ChatGPT, Gemini) znają one jedynie to, co zawierają ich dane szkoleniowe. W tym przypadku informacje o nowych programach często wykraczają poza zakres danych szkoleniowych modelu „ LLM”, co uniemożliwia mu pomoc widzom w znalezieniu tego, czego szukają. Na przykład komedia „Rooster” z Steve’em Carellem w roli głównej jest zbyt nowa, by model LLM wydany w 2025 roku posiadał na jej temat jakiekolwiek informacje.
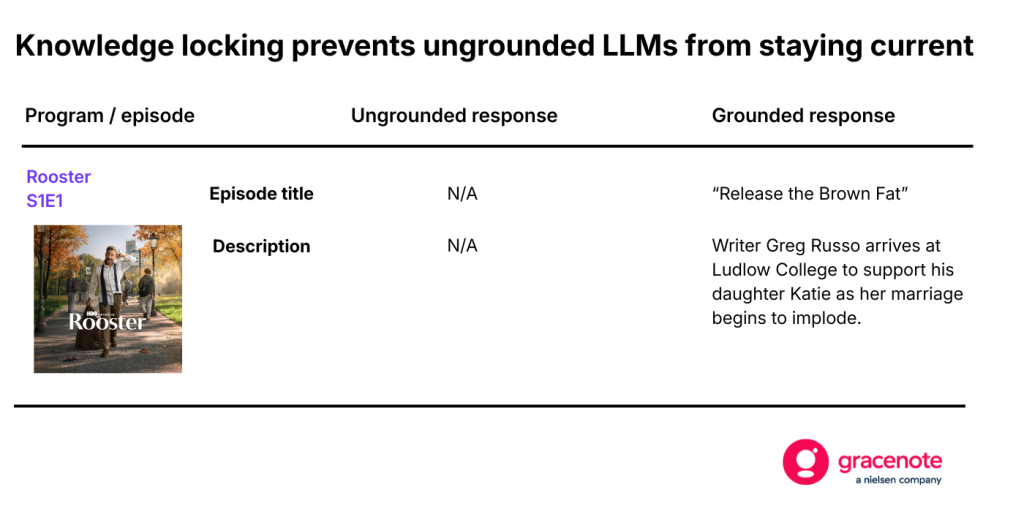
Reakcje na program „ LLM ” bez uzasadnienia a wrażenia widzów
Jak szczegółowo opisano w naszym najnowszym raporcie „Luki fabularne w sztucznej inteligencji ”, modele LLM pozbawione danych kontekstowych mają trudności z udzielaniem trafnych odpowiedzi na pytania dotyczące podstawowych atrybutów popularnych seriali telewizyjnych i filmów. W przypadku treści epizodycznych ta wada jest znacznie bardziej widoczna. Wynika to z faktu, że atrybuty metadanych są znacznie bardziej unikalne na poziomie poszczególnych odcinków niż na poziomie tytułów programów.
Zgadywanie na podstawie kontekstu, prawdopodobieństwo przewidywania oraz brak możliwości indeksowania – wszystkie te czynniki znacznie zwiększają prawdopodobieństwo, że serwis LLM , nieposiadający żadnych danych, wygeneruje błędne wyniki, gdy jedyne informacje, na podstawie których może działać, to tytuł programu, numer sezonu i numer odcinka. Co ważne, widzowie rzadko wyszukują odcinki na podstawie ich tytułów.
Aby lepiej zrozumieć znaczenie powiązania z konkretnymi odcinkami w procesie wyszukiwania i odkrywania treści, niedawno oceniliśmy jakość nieopartych na konkretnych odcinkach wyników wyszukiwania w serwisie LLM w odpowiedzi na podstawowe pytania dotyczące konkretnych odcinków seriali telewizyjnych. Chociaż użytkownicy zazwyczaj nie wyszukują informacji w ten sposób, w naszych zapytaniach wykorzystaliśmy numery sezonów i odcinków, aby ocenić dokładność odpowiadających im metadanych. Badanie objęło 100 popularnych odcinków z 13 krajów (łącznie 1 300).
Ogólnie rzecz biorąc, dokładność merytoryczna odpowiedzi dotyczących odcinków seriali była znacznie niższa niż w przypadku seriali telewizyjnych i filmów. Na przykład wśród 100 najpopularniejszych odcinków w Stanach Zjednoczonych średnio tylko 27% opisów programów byłozgodnych z rzeczywistością², podczas gdy w przypadku 100 najpopularniejszych seriali telewizyjnych i 100 filmów średnia ta wynosiła 69%.
Dokładność nie była jedyną cechą, z którą borykał się pozbawiony podstaw faktograficznych serwis „ LLM ” w 1 300 odcinkach (po 100 na kraj) objętych badaniem. Jeszcze większym problemem był brak dostępu do informacji, ponieważ serwis ten nie dysponował żadnych danych (tytułu, opisu, obsady, gatunku) dotyczących 604 odcinków (46,5% ogółu). Najbardziej widoczne było to w Szwecji, gdzie nie podano żadnych informacji o 73 z 100 odcinków. W Stanach Zjednoczonych serwis LLM nie podał żadnych informacji o 31 odcinkach.
Ten z błędną fabułą
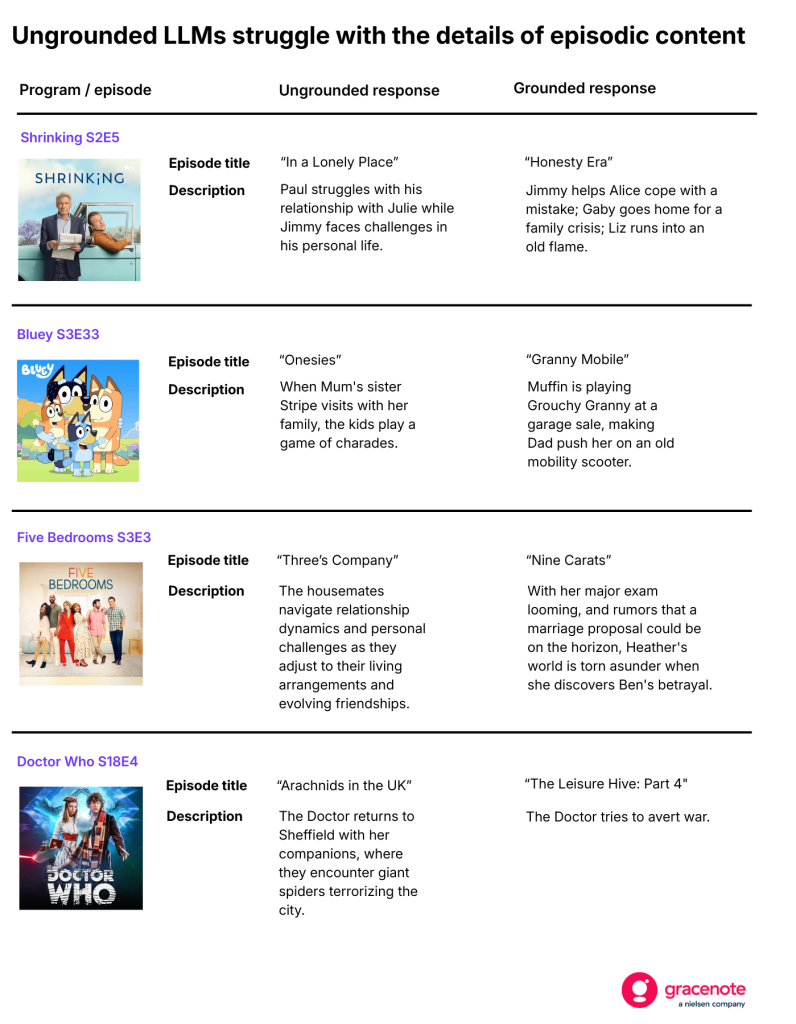
Gdy serwis „ LLM ”, który nie był podłączony do sieci, nie zwracał pustych odpowiedzi, często podawał błędne opisy odcinków — co wynikało z domysłów semantycznych, prawdopodobieństwa predykcyjnego oraz braku indeksowania. Chociaż widzowie prawdopodobnie nigdy nie szukaliby odcinka, podając jedynie numer serii i numer odcinka, serwisy streamingowe wykorzystują te atrybuty do przekształcania uzyskanych tytułów odcinków w głębokie linki lub powiązane rekordy w swoim jeziorze danych. W tym przypadku harmonizacja danych na zapleczu i indeksowanie mają kluczowe znaczenie dla zapewnienia, że serwis może dokładnie dostarczyć odpowiednią treść dla każdego indywidualnego widza.
Ponieważ każde zapytanie zawierało jedynie numer serii i numer odcinka, serwis LLM , który nie posiadał konkretnych danych, często podawał opisy przedstawiające szczegóły zupełnie innych odcinków niż te, o które pytano. W poniższych przykładach tytuły i opisy podane przez serwis LLM są nieprawidłowe.
Połączenie z siecią ma kluczowe znaczenie dla wrażeń związanych z treściami nowej generacji
Zmieniają się sposoby, w jakie konsumenci poszukują informacji, oraz narzędzia, z których korzystają. Korzystanie z GenAI jest powszechne wśród pokolenia cyfrowego, a jego popularność szybko rośnie.
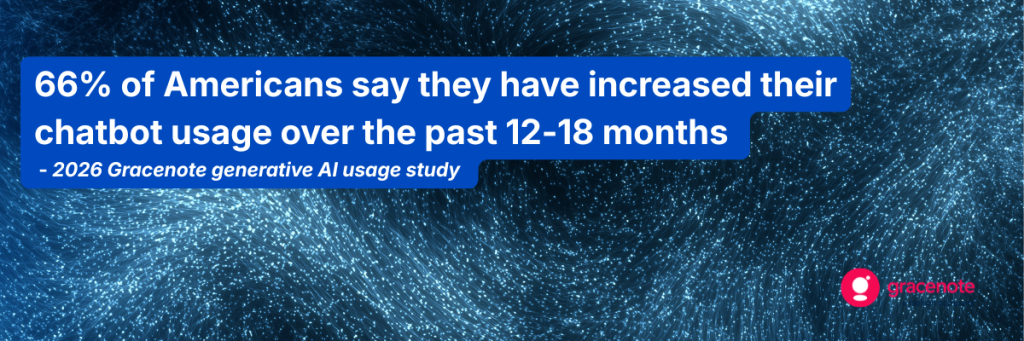
Dzisiejszy świat treści jest zbyt rozległy, by można było się w nim poruszać za pomocą przestarzałych funkcji wyszukiwania — nawet w obrębie poszczególnych platform i serwisów. Wykorzystanie sztucznej inteligencji generatywnej (GenAI) do wyszukiwania i odkrywania treści stanowi przełomową zmianę w doświadczeniu użytkownika, która może znacznie zmniejszyć negatywne nastawienie odbiorców w miarę narastania nadmiaru treści.
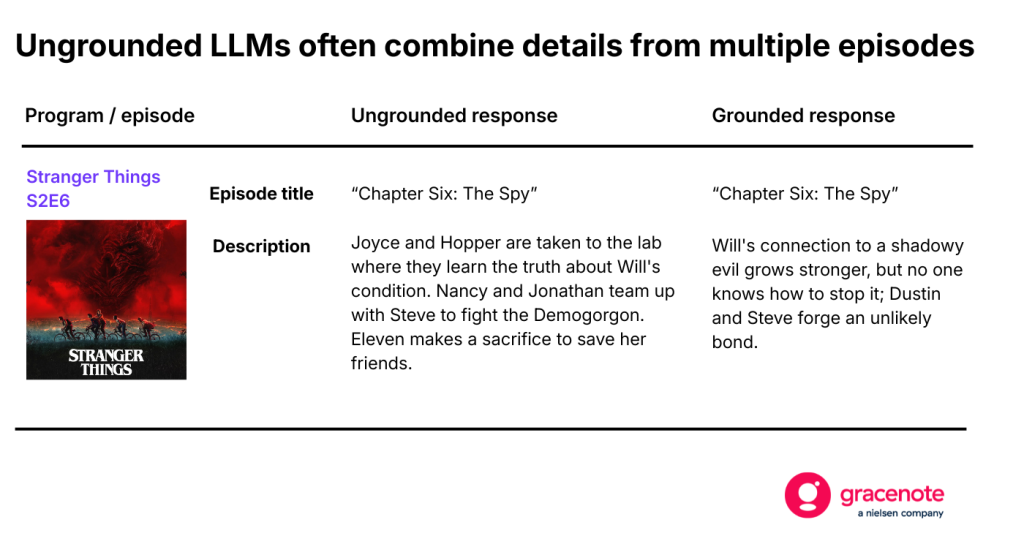
Jednak w odpowiedzi na pytanie dotyczące odcinka S02E06 serialu „Stranger Things” nieuzasadniona odpowiedź serwisu „ LLM” łączyła informacje z kilku różnych odcinków. W takiej sytuacji widz ostatecznie zacznie tracić zaufanie do serwisu, co jest już powszechnym zjawiskiem wśród obecnych użytkowników chatbotów: 75% z nich twierdzi, że weryfikuje wyniki dostarczane przez chatboty oparte na sztucznej inteligencji, ponieważ obawiają się, że mogą one byćnieprawidłowe³.
W tym scenariuszu końcowym skutkiem jest słaba jakość obsługi — co może sprawić, że widz zacznie szukać czegoś do obejrzenia gdzie indziej.
Aby uzyskać dodatkowe informacje na temat wykorzystania nieuziemionych modeli LLM w procesach wyszukiwania i odkrywania treści, pobierz nasz raport „Luki w sztucznej inteligencji”.
Uwagi
- LLM to rodzaj generatywnej sztucznej inteligencji, która jest szkolona na ogromnych ilościach danych w celu zrozumienia i generowania języka przypominającego ludzki.
- W porównaniu z danymi dotyczącymi uziemienia.
- Gracenote Badanie dotyczące wykorzystania technologii GenAI z 2026 r.
Dlaczego doświadczenie użytkownika jest najważniejszym wskaźnikiem satysfakcji
W obliczu rosnącej fragmentacji treści wideo widzowie nie mogą znaleźć tego, czego szukają. Pomóc w tym może lepszy komfort użytkowania.
2026 State of Play
Oferta usług streamingowych stała się wszechstronna, co potęguje rosnące wyzwania związane z odkrywaniem treści.
Koszt fragmentacji: Trudności związane z dostępem do transmisji sprawiają, że fani sportu sięgają po skróty meczów
Dla fanów sportu większą przeszkodą jest dostęp do transmisji niż koszt subskrypcji.