Il mondo sta diventando sempre più orientato alla conversazione e la GenAI sta aiutando le persone a orientarsi in un mondo sempre più complesso. Nel mondo dell’intrattenimento, i telespettatori utilizzano la ricerca vocale per districarsi nella mole crescente di contenuti video, che continua a frammentarsi tra canali e servizi diversi.
Nonostante la diffusione delle funzionalità vocali su tutti i dispositivi, tuttavia, l’utilità di questa tecnologia dipende dai dati: informazioni concrete e in tempo reale che un LLM1 utilizza per convalidare, integrare e correggere le risposte fornite alle richieste degli utenti. Nel panorama dello streaming, ciò è particolarmente importante per i contenuti a episodi.
Non solo la quantità di contenuti a episodi supera di gran lunga il numero di film disponibili, ma il pubblico cerca gli episodi delle serie TV in modo diverso rispetto a come cerca i film. Gli spettatori raramente conoscono la stagione o l’episodio specifico che desiderano guardare, specialmente nel caso di serie di lunga durata come NCIS, Grey’s Anatomy e I Simpson. Pertanto, quando effettuano una ricerca, utilizzano query contestuali come “Mostrami gli episodi natalizi di The Office”e “In quali episodi di Friends compare Bruce Willis come guest star?”.
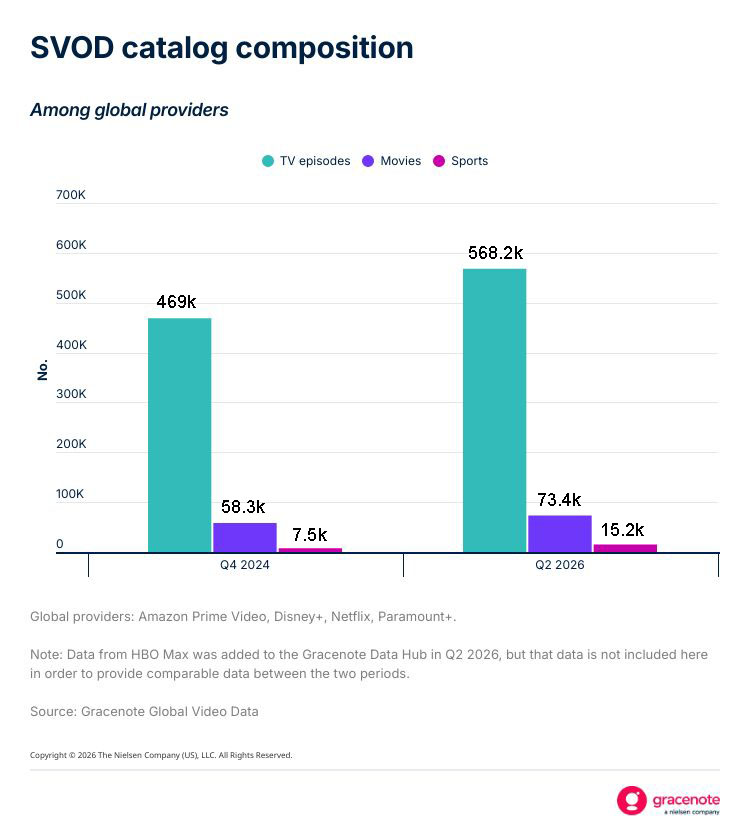
In questi casi, le risposte fornite da LLM saranno solitamente errate. Ciò è dovuto al fatto che basano le loro risposte su calcoli di probabilità che tengono conto della stagione e del numero dell’episodio. Per i fornitori, la scarsa esperienza utente associata a risposte errate aggraverà la frustrazione causata dalla crescente frammentazione dei contenuti. I contenuti a episodi giocano un ruolo importante nella congestione dei contenuti, poiché gli episodi televisivi rappresentano l’85% dei contenuti distribuiti dai sei fornitori globali di SVOD monitorati nel Gracenote Data Hub.
Con l'aumentare dei cataloghi video, la GenAI diventerà sempre più utile per gli spettatori alla ricerca di qualcosa da guardare. In appena un anno e mezzo, ad esempio, il numero di episodi televisivi a disposizione del pubblico è aumentato di oltre il 21%.
Grazie a funzionalità quali la ricerca conversazionale, immagini personalizzate dei programmi, consigli su misura e highlights sportivi in tempo reale, la GenAI rivoluzionerà il modo in cui gli spettatori interagiscono con i contenuti video.
Per offrire queste funzionalità — e fornirle in modo pertinente e personalizzato — i modelli di linguaggio di grandi dimensioni (LLM) che sono alla base della ricerca e della scoperta dei contenuti devono poter accedere a dati accurati ed esaustivi sul mondo dell’intrattenimento. Ciò vale in particolare per il 50% degli americani che dichiara che prenderebbe in considerazione la possibilità di disdire un abbonamento se questo non fornisse contenuti diloro interesse2.
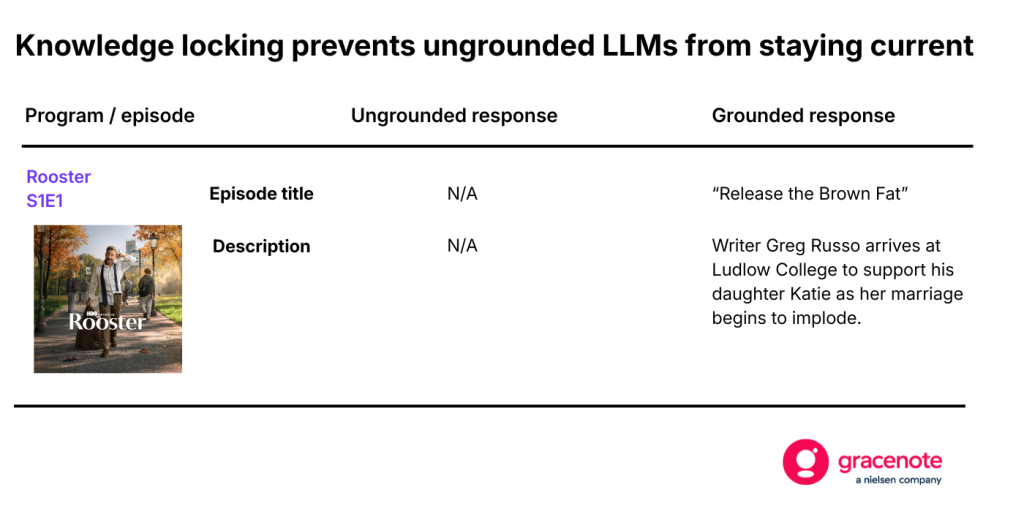
Il collegamento a dati convalidati e in tempo reale è fondamentale, poiché i modelli di linguaggio di grandi dimensioni (LLM) implementati per uso aziendale non si basano su alcuna fonte di informazioni esterna. A differenza dei chatbot più diffusi (ad esempio ChatGPT, Gemini), essi conoscono solo ciò che viene fornito dai loro dati di addestramento. In questo caso, le informazioni sui nuovi programmi spesso non rientrano nei dati di addestramento di un modello di linguaggio di grandi dimensioni ( LLM), impedendo loro di aiutare gli spettatori a trovare ciò che stanno cercando. La commedia «Rooster», con Steve Carell, ad esempio, è troppo recente perché un LLM lanciato nel 2025 possa disporre di informazioni al riguardo.
Risposte non fondate di “ LLM ” e l’esperienza dello spettatore
Come illustrato nel nostro recente rapporto “Plot holes in AI”, i modelli di linguaggio di grandi dimensioni (LLM) privi di contestualizzazione faticano a fornire risposte accurate quando vengono interrogati sugli attributi di base di serie TV e film famosi. Quando si tratta di contenuti a episodi, questa lacuna è molto più marcata. Ciò è dovuto al fatto che gli attributi dei metadati sono molto più specifici a livello di episodio rispetto a quelli relativi al titolo del programma.
Le supposizioni semantiche, la probabilità predittiva e la mancanza di funzionalità di indicizzazione contribuiscono tutte ad aumentare notevolmente la probabilità che un LLM non ben informato fornisca risultati errati quando ha a disposizione solo il titolo di una serie, il numero della stagione e il numero dell’episodio. E, cosa importante, gli spettatori raramente cercano un episodio utilizzando il suo titolo.
Per comprendere meglio l’importanza di basarsi su dati concreti nella ricerca e nella scoperta a livello di episodio, abbiamo recentemente valutato la qualità delle risposte non basate su dati concreti fornite da LLM a domande di base su specifici episodi televisivi. Sebbene le persone non effettuino ricerche in questo modo, abbiamo utilizzato i numeri delle stagioni e degli episodi nelle nostre query per valutare l’accuratezza dei metadati corrispondenti. Lo studio ha incluso 100 episodi popolari provenienti da 13 paesi (1.300 in totale).
Nel complesso, l’accuratezza fattuale delle risposte relative agli episodi è risultata significativamente inferiore rispetto a quella relativa alle serie TV e ai film. Tra i 100 episodi più seguiti negli Stati Uniti, ad esempio, in media solo il 27% delle descrizioni dei programmi eraaccurato², rispetto a una media del 69% delle descrizioni relative alle 100 serie TV e ai 100 film più seguiti.
L'accuratezza non è stata l'unica lacuna riscontrata nell'LLM , privo di fondamento, nei 1.300 episodi (100 per paese) analizzati nello studio. La disponibilità delle informazioni rappresentava un problema ancora più grave, poiché il programma non disponeva alcuna informazioni (titolo, descrizione, attori, genere) per 604 episodi (il 46,5% del totale). Ciò è risultato particolarmente evidente in Svezia, dove non sono state fornite informazioni per 73 dei 100 episodi. Negli Stati Uniti, l’ LLM non ha fornito informazioni per 31 episodi.
Quello con la trama sbagliata
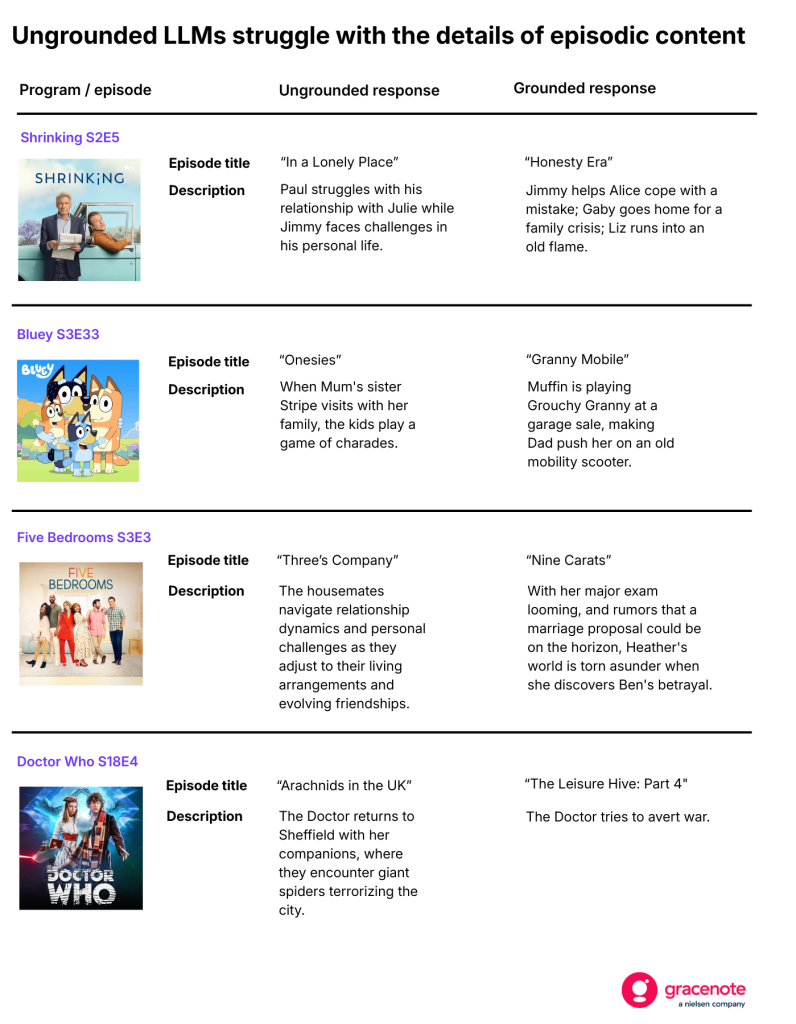
Quando l’ LLM , non collegato a terra, non restituiva risposte vuote, forniva spesso descrizioni errate degli episodi: un effetto collaterale delle ipotesi semantiche, della probabilità predittiva e della mancanza di indicizzazione. Sebbene gli spettatori probabilmente non cercherebbero mai un episodio utilizzando solo il numero della serie e quello dell’episodio, i servizi di streaming utilizzano questi attributi per convertire i titoli degli episodi risultanti in deep link o in un record associato nel loro data lake. In questo contesto, l’armonizzazione dei dati nel backend e l’indicizzazione sono fondamentali per garantire che un servizio possa restituire con precisione i contenuti giusti per ogni singolo spettatore.
Poiché in ogni query erano presenti solo il numero della serie e quello dell’episodio, l’ LLM , non contestualizzato, forniva spesso descrizioni che riportavano i dettagli di episodi completamente diversi da quelli oggetto della richiesta. Negli esempi riportati di seguito, i titoli e le descrizioni forniti dall’ LLM non contestualizzato sono errati.
La connessione a terra è fondamentale per le esperienze di contenuto di nuova generazione
Il modo in cui i consumatori cercano informazioni e gli strumenti che utilizzano stanno cambiando. L'uso della GenAI è ormai una pratica consolidata tra i nativi digitali e la sua diffusione si sta rapidamente ampliando.
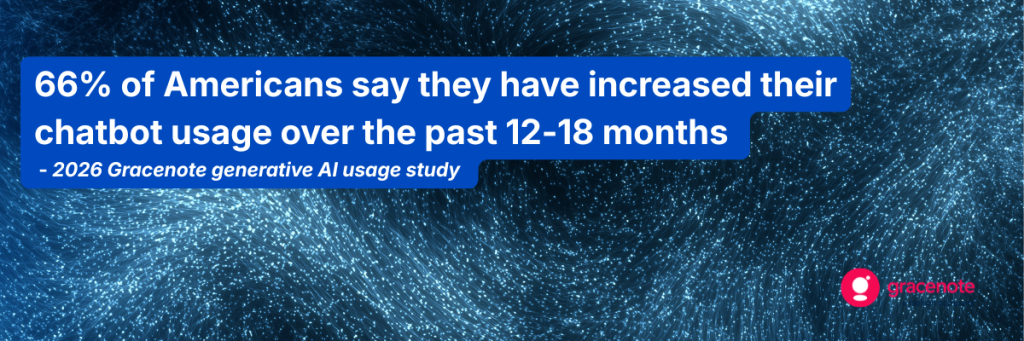
Il panorama dei contenuti odierno è troppo vasto per poter essere esplorato con le funzioni di ricerca tradizionali, anche all’interno delle singole piattaforme e dei singoli servizi. L’uso della GenAI per la ricerca e la scoperta dei contenuti rappresenta un cambiamento epocale nell’esperienza utente, che ha il potenziale di ridurre notevolmente il sentiment negativo degli utenti man mano che la sovraccarico di contenuti continua ad aumentare.
Ma quando gli è stato chiesto dell’episodio S02E06 di *Stranger Things*, la risposta infondata di LLMha mescolato informazioni provenienti da diversi episodi. A questo punto, lo spettatore finirà per perdere fiducia nel servizio, un fenomeno già diffuso tra gli attuali utenti dei chatbot: il 75% dichiara di verificare i risultati forniti dai chatbot basati sull’intelligenza artificiale perché teme che sianoerrati³.
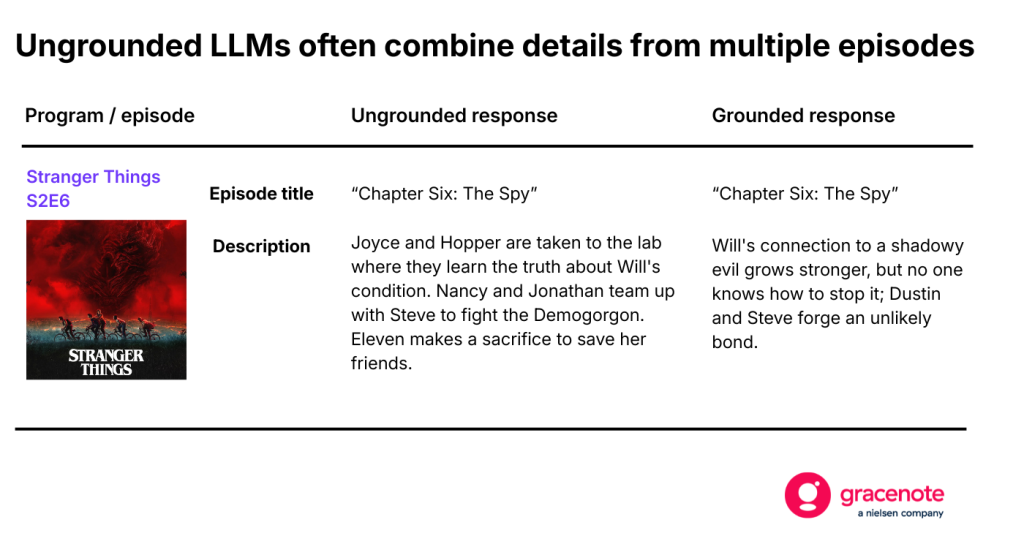
Il risultato finale in questo scenario è un'esperienza utente deludente, che potrebbe indurre lo spettatore a cercare altrove qualcosa da guardare.
Per ulteriori approfondimenti sull'uso dei modelli di linguaggio di grandi dimensioni (LLM) non addestrati nelle esperienze di ricerca e scoperta dei contenuti, scarica il nostro rapporto "Plot holes in AI".
Note
- Gli LLM sono una tipologia di IA generativa addestrata su enormi quantità di dati per comprendere e generare un linguaggio simile a quello umano.
- Se confrontati con i dati relativi all'ancoraggio.
- Gracenote Studio sull'utilizzo di GenAI del 2026
Perché l'esperienza utente è l'indicatore di soddisfazione per eccellenza
A causa della crescente frammentazione dei contenuti video, gli spettatori non riescono a trovare ciò che cercano. Un’esperienza utente (UX) migliore può essere d’aiuto.
2026 State of Play
L'offerta di servizi di streaming è diventata sempre più completa, accentuando le crescenti difficoltà legate alla scoperta dei contenuti.
Il costo della frammentazione: le difficoltà di accesso ai contenuti stanno spingendo gli appassionati di sport verso i momenti salienti
Per gli appassionati di sport, la difficoltà di trovare i contenuti è un ostacolo maggiore rispetto al costo dell'abbonamento.