O mundo está se tornando cada vez mais interativo, e a GenAI está ajudando as pessoas a navegar por um mundo cada vez mais complexo. No mundo do entretenimento, os telespectadores estão usando a pesquisa por voz para se orientar no mar de conteúdo de vídeo, que continua se fragmentando entre canais e serviços.
Apesar da prevalência da funcionalidade de voz em diversos dispositivos, no entanto, a utilidade dessa tecnologia depende dos dados — informações do mundo real e em tempo real que umLLM1 utiliza para validar, fundamentar e corrigir as respostas que fornece às consultas dos usuários. No cenário do streaming, isso é especialmente crítico para conteúdos episódicos.
Não só a quantidade de conteúdo episódico supera em muito o número de filmes disponíveis, como o público pesquisa episódios de séries de TV de maneira diferente daquela usada para pesquisar filmes. Os espectadores raramente sabem a temporada ou o episódio específico que querem assistir, especialmente no caso de séries que já estão no ar há muito tempo, como NCIS, Grey’s Anatomy e Os Simpsons. Por isso, quando fazem uma busca, usam consultas contextuais como “Mostre-me os episódios de Natal de The Office”e “Em quais episódios de Friends Bruce Willis aparece como convidado especial?”
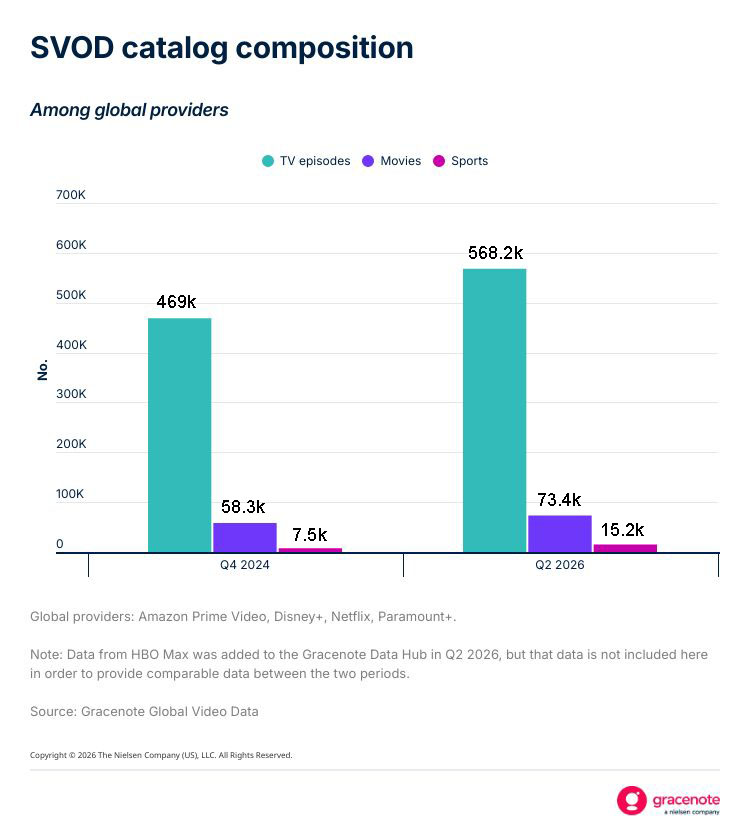
Nesses casos, as respostas dos LLMs geralmente estarão incorretas. Isso ocorre porque elas se baseiam na probabilidade, utilizando os números da temporada e do episódio. Para os provedores, a experiência ruim do usuário associada a respostas incorretas agravará as frustrações decorrentes da crescente fragmentação de conteúdo. O conteúdo episódico desempenha um papel importante no congestionamento de conteúdo, já que os episódios de séries de TV representam 85% do conteúdo distribuído pelos seis provedores globais de SVOD monitorados no Gracenote Data Hub.
À medida que os catálogos de vídeo crescem, a GenAI se tornará cada vez mais útil para os espectadores que procuram algo para assistir. Em apenas um ano e meio, por exemplo, a quantidade de episódios de séries de TV disponíveis para o público aumentou em mais de 21%.
Ao oferecer recursos como pesquisa conversacional, imagens personalizadas dos programas, recomendações sob medida e destaques esportivos em tempo real, a GenAI transformará a forma como os espectadores interagem com o conteúdo de vídeo.
Para oferecer esses recursos — e disponibilizá-los de maneira relevante e personalizada —, os LLMs que impulsionam a pesquisa e a descoberta precisam ter acesso a dados precisos e abrangentes sobre entretenimento. Isso é especialmente verdadeiro para os 50% dos americanos que afirmam que considerariam cancelar um serviço caso ele não ofereça conteúdo deseu interesse².
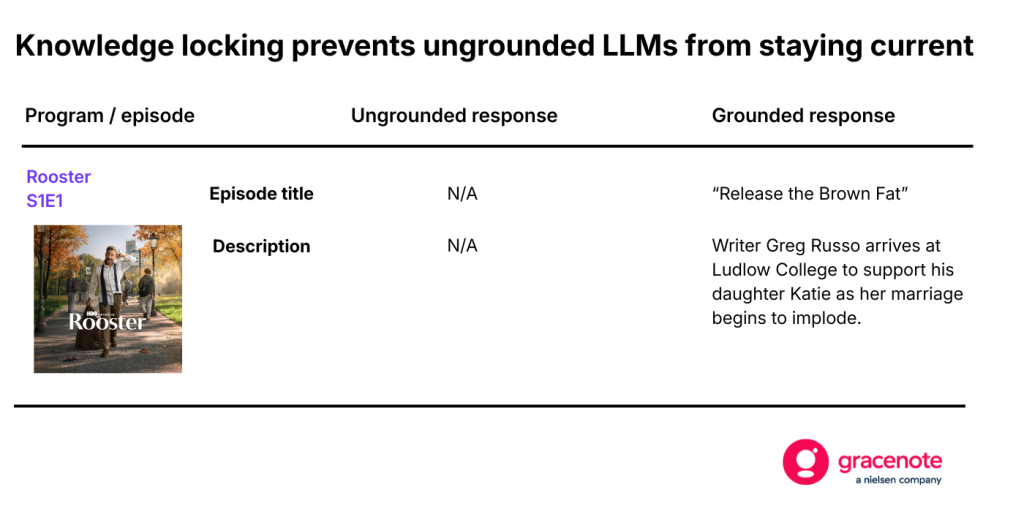
A conexão com dados validados e em tempo real é fundamental, já que os LLMs implantados para uso corporativo não se baseiam em nenhuma fonte de informação externa. Ao contrário dos chatbots populares (por exemplo, ChatGPT, Gemini), eles só sabem o que seus dados de treinamento fornecem. Nesse caso, as informações sobre novos programas muitas vezes ficam fora dos dados de treinamento de um LLM, deixando-os sem a capacidade de ajudar os usuários a encontrar o que estão procurando. A comédia “Rooster”, estrelada por Steve Carell, por exemplo, é recente demais para que um LLM lançado em 2025 tenha qualquer informação a respeito.
Respostas de LLMs sem fundamento e a experiência do usuário
Conforme detalhado em nosso recente relatório “Falhas no enredo da IA ”, os LLMs sem contexto têm dificuldade em fornecer respostas precisas quando questionados sobre atributos básicos de séries de TV e filmes populares. Quando se trata de conteúdo episódico, essa deficiência é muito mais pronunciada. Isso ocorre porque os atributos de metadados são muito mais específicos no nível do episódio do que no nível do título do programa.
Suposições semânticas, probabilidade preditiva e a falta de recursos de indexação contribuem para uma probabilidade muito maior de que um LLM sem contexto tenha alucinações quando tudo o que ele tem para trabalhar é o título de um programa, o número da temporada e o número do episódio. E, o que é importante, os espectadores raramente procuram um episódio pelo título.
Para compreender melhor a importância da contextualização na pesquisa e na descoberta no nível dos episódios, avaliamos recentemente a qualidade das respostas de LLMs sem contextualização a perguntas básicas sobre episódios específicos de séries de TV. Embora as pessoas não façam pesquisas dessa forma, utilizamos os números das temporadas e dos episódios em nossas consultas para avaliar a precisão dos metadados correspondentes. O estudo incluiu 100 episódios populares de 13 países (1.300 no total).
No geral, a precisão factual das respostas relativas aos episódios foi significativamente menor do que a observada para séries de TV e filmes. Entre os 100 episódios mais populares nos EUA, por exemplo, apenas 27% das descrições dos programas, em média, estavamcorretas², em comparação com uma média de 69% das descrições das 100 séries de TV e dos 100 filmes mais populares.
A precisão não foi o único aspecto com o qual o LLM sem contexto teve dificuldades ao longo dos 1.300 episódios (100 por país) do estudo. A falta de informações foi um problema ainda maior, já que ele não possuía nenhuma informações (título, descrição, atores, gênero) para 604 dos episódios (46,5% do total). Isso ficou mais evidente na Suécia, onde nenhuma informação foi fornecida para 73 dos 100 episódios. Nos EUA, o LLM sem treinamento específico não forneceu informações para 31 episódios.
Aquele com o enredo errado
Quando o LLM sem treinamento não retornava respostas vazias, frequentemente fornecia descrições incorretas dos episódios — um subproduto de suposições semânticas, probabilidade preditiva e falta de indexação. Embora os espectadores provavelmente nunca pesquisassem um episódio usando apenas o número da série e o número do episódio, os serviços de streaming utilizam esses atributos para converter os títulos dos episódios resultantes em links diretos ou em um registro associado em seu data lake. Nesse contexto, a harmonização e a indexação de dados no back-end são fundamentais para garantir que um serviço possa retornar com precisão o conteúdo correto para cada espectador individualmente.
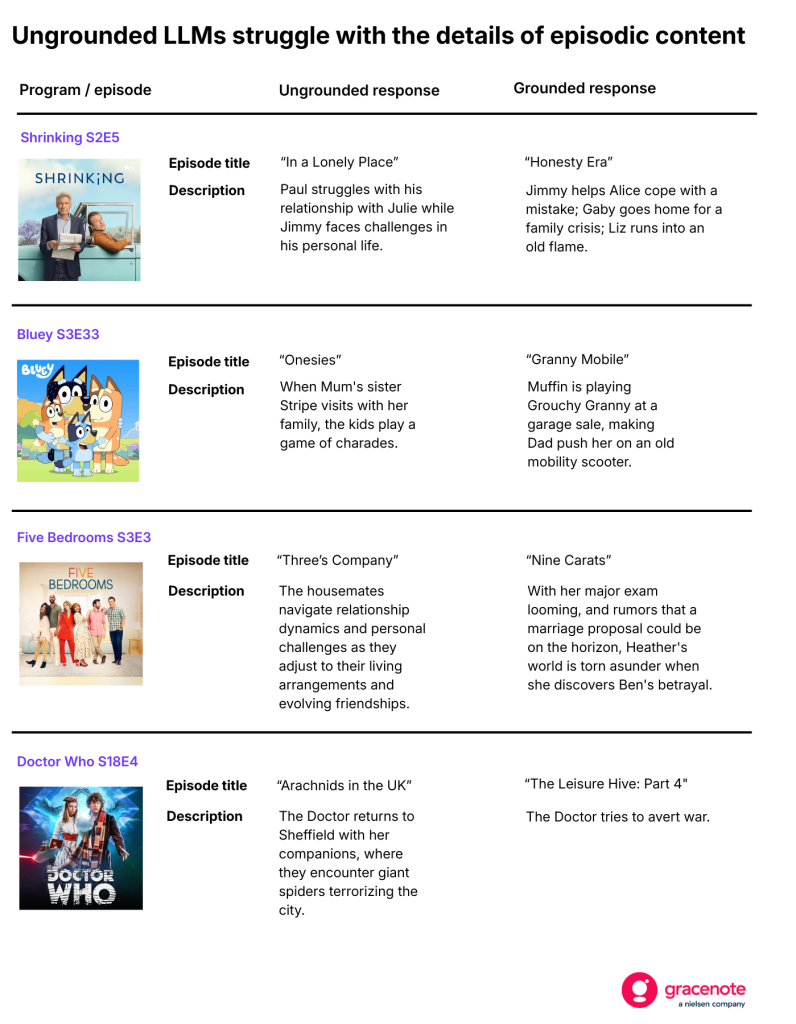
Com apenas o número da série e o número do episódio em cada consulta, o LLM sem contextualização frequentemente fornecia descrições que detalhavam episódios totalmente diferentes daqueles sobre os quais se perguntava. Nos exemplos abaixo, os títulos e as descrições fornecidos pelo LLM sem contextualização estão incorretos.
O “grounding” é fundamental para as experiências de conteúdo da próxima geração
A forma como os consumidores buscam informações e as ferramentas que utilizam estão mudando. O uso da IA Gerativa é comum entre os nativos digitais, e sua adoção está se expandindo rapidamente.
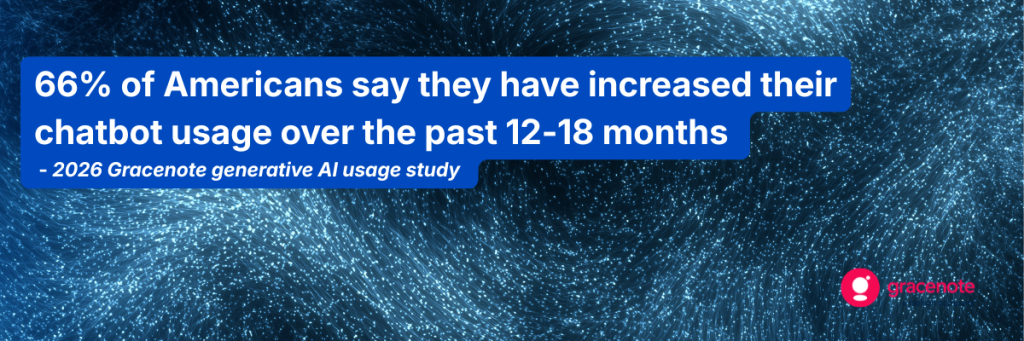
O panorama atual de conteúdo é vasto demais para ser explorado com funções de busca tradicionais — mesmo dentro de plataformas e serviços específicos. O uso da IA de Geração (GenAI) para a busca e descoberta de conteúdo representa uma mudança radical na experiência do usuário, com potencial para reduzir significativamente o sentimento negativo dos espectadores à medida que o congestionamento de conteúdo aumenta.
Mas, quando questionado sobre o episódio S02E06 de “Stranger Things”, a resposta do LLM sem base combinou informações de vários episódios diferentes. Nesse caso, o espectador acabará por perder a confiança no serviço, o que já é comum entre os usuários atuais de chatbots: 75% afirmam que verificam os resultados fornecidos pelos chatbots de IA porque temem que estejamincorretos³.
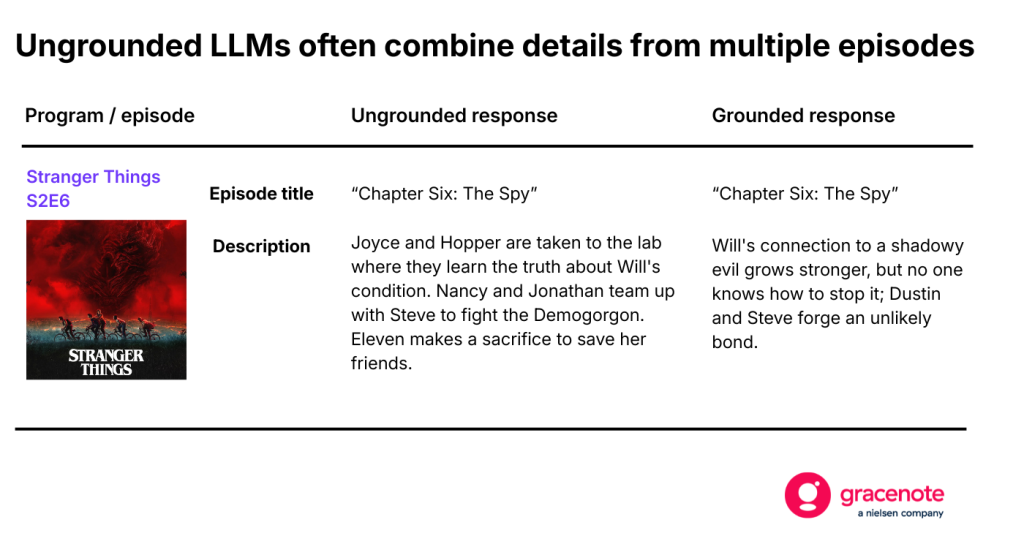
O resultado final nesse cenário é uma experiência do usuário insatisfatória — o que pode levar o espectador a procurar em outro lugar algo para assistir.
Para obter mais informações sobre o uso de LLMs sem base na pesquisa e na descoberta de conteúdo, baixe nosso Relatório “Lacunas na IA”.
Notas
- Os LLMs são um tipo de IA generativa treinada com enormes quantidades de dados para compreender e gerar linguagem semelhante à humana.
- Quando comparado com os dados de aterramento.
- Gracenote Estudo sobre o uso da GenAI em 2026
O custo da fragmentação: os desafios da descoberta estão levando os fãs de esportes a buscar os melhores momentos
Para os fãs de esportes, a dificuldade em encontrar conteúdo é um obstáculo maior do que o custo da assinatura.
Como resolver a rotatividade no setor esportivo: a vantagem da tela inicial no streaming moderno
Reunir em um só lugar tudo o que os fãs procuram pode reduzir a rotatividade e promover o engajamento a longo prazo.
Vantagem da tela inicial
Centros esportivos centralizados poderiam representar uma virada de jogo para os provedores de conteúdo.