Como o RAG e o MCP se diferenciam na criação de experiências de TV baseadas em IA
A crescente presença da inteligência artificial (IA) em nosso dia a dia intensificou o desejo dos consumidores por personalização e rapidez. No mundo do entretenimento, as pessoas esperam respostas imediatas, sugestões personalizadas e a possibilidade de agir com base no que veem e ouvem. Para alguns, isso significa encontrar o filme perfeito para um determinado estado de espírito; para outros, significa encontrar a partida entre seu time favorito e seu maior rival.
Para proporcionar essas experiências, editoras, plataformas e serviços recorrerão cada vez mais a grandes modelos de linguagem (LLMs)1, que se tornarão os mecanismos padrão para os ambientes de entretenimento da próxima geração.
Os LLMs são matrizes de probabilidade, não bancos de dados, treinados com dados exaustivos, mas finitos. A natureza fundamental dessa tecnologia inovadora significa que os LLMs sintetizam, mas não recuperam, dados e, portanto, estão sujeitos a “alucinações”, nas quais apresentam dados que parecem plausíveis, mas estão incorretos. Para garantir que as respostas d LLM m sejam precisas, relevantes e confiáveis, os LLMs devem estar conectados a fontes complementares de conhecimento do mundo real. Esse processo de “ancoragem” reduz erros, enriquece os resultados e proporciona relevância contextual. Existem dois métodos principais para a ancoragem de LLMs: a geração aumentada por recuperação (RAG) e o Protocolo de Contexto do Modelo (MCP).
Tanto o RAG quanto o MCP abordam as limitações dos LLMs, mas tratam da questão de maneiras fundamentalmente diferentes.
Em linhas muito gerais:
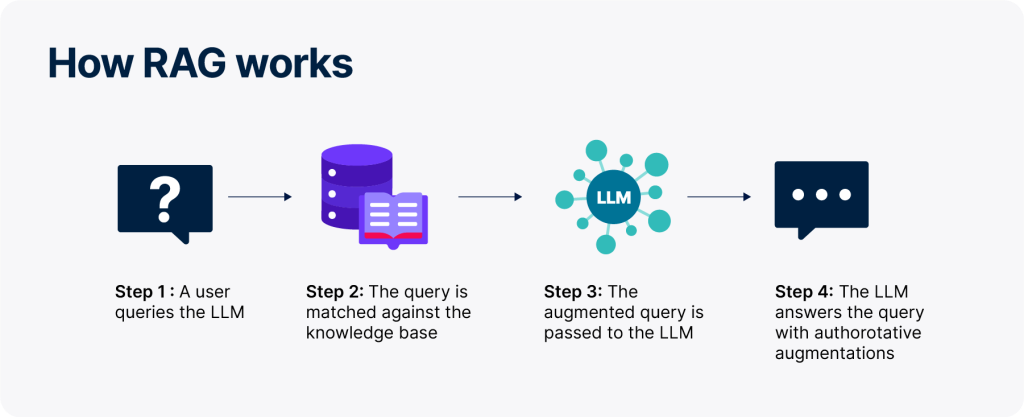
O RAG envolve um processo no qual a solicitação original é enriquecida com dados relevantes provenientes de uma base de conhecimento externa composta por documentos pertinentes. Ele processa essa solicitação enriquecida, e sua resposta reflete a precisão dos dados provenientes do aumento de conhecimento externo.
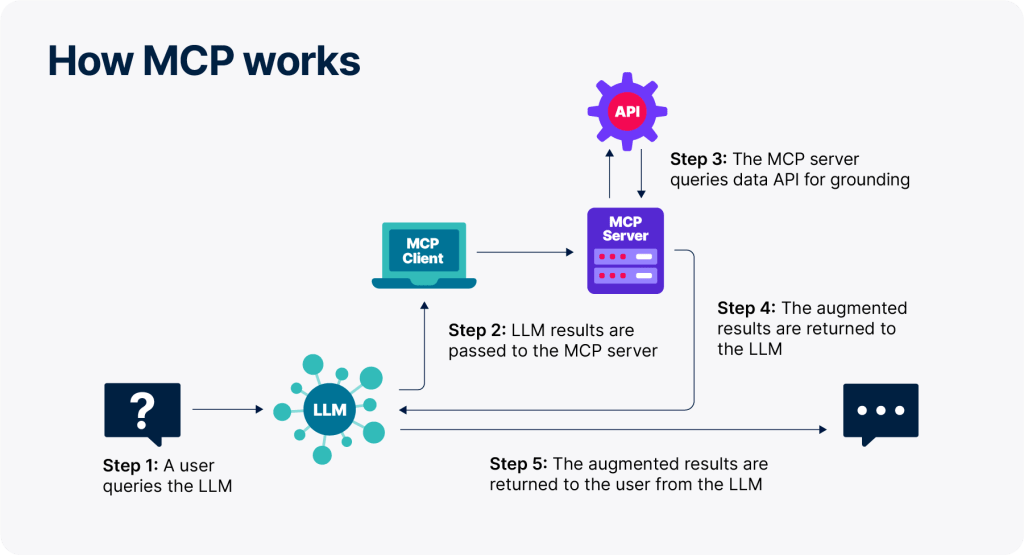
O MCP é um protocolo de código aberto que padroniza a forma como os aplicativos fornecem contexto aos LLMs. Como uma interface universal, às vezes descrita como o “USB-C da IA”, o MCP conecta os LLMs a fontes de dados e lógicas externas, eliminando a necessidade de programação e integrações personalizadas. Nesse caso, um “ LLM ” é conectado a um ou mais servidores MCP que facilitam a validação em tempo real das consultas recebidas.
RAG: o especialista em recuperação de documentos
Entre as duas técnicas, a RAG é a que tem mais história. Com origens nos primórdios da recuperação de informações, a RAG foi discutida pela primeira vez em 2020 como um processo para conectar dinamicamente os LLMs a repositórios de conhecimento externos.
Em termos simples, o RAG permite que os LLMs consultem informações fora de seus dados de treinamento antes de responder a uma consulta do usuário. Com o RAG, os LLMs não precisam ser constantemente retreinados para se manterem atualizados. Em vez disso, atualizações periódicas na base de conhecimento externa mantêm as respostas de um LLMatualizadas e relevantes.
Embora o RAG melhore significativamente a precisão e a relevância dos resultados d LLM , ele apresenta algumas limitações:
- O RAG é mais eficaz quando utilizado na recuperação de informações não estruturadas e baseadas em documentos.
- O RAG enriquece o prompt antes que o modelo de linguagem de geração ( LLM ) comece a processá-lo, de modo que o modelo de linguagem de geração ( LLM ) não possa utilizar sua lógica interna para extrair informações relevantes.
MCP: O facilitador de ações em tempo real
Disponibilizado no final de 2024 como um protocolo de código aberto, o MCP resolve o desafio de desenvolver integrações personalizadas entre fontes de dados e modelos de IA. Como um conector universal, o MCP cria uma interface entre um modelo de linguagem grande ( LLM , LLM) e fontes de dados externas. Com uma API de baixa latência e uma interface uniforme e abstraída, o MCP permite que os LLMs obtenham informações atualizadas em tempo real de um ou mais serviços específicos de domínio e que invoquem ferramentas específicas que lhes permitam fornecer a melhor resposta possível.
Com o MCP, os LLMs podem ser integrados a diversas fontes de dados de maneira transparente, permitindo o acesso a dados e a ações em tempo real. Graças a essa arquitetura, o MCP fundamenta suas respostas em bases de conhecimento externas após uma consulta do usuário, tornando-o ideal para cenários que exigem as informações mais atualizadas disponíveis, como resultados esportivos ou variações nos preços das ações.
O MCP é a tecnologia certa para o entretenimento do futuro
O RAG e o MCP foram projetados, por natureza, para realizar a mesma função: enriquecer as respostas d LLM e com contexto externo, a fim de reduzir alucinações e proporcionar relevância contextual. No entanto, eles se destacam em diferentes tipos de dados, oferecem diferentes níveis de sofisticação e os métodos que utilizam para executar essa tarefa são fundamentalmente diferentes.
O RAG é mais adequado para a recuperação de dados não estruturados, como documentos, enquanto o MCP é otimizado para o acesso a dados estruturados em tempo real. Embora os LLMs ofereçam experiências de pesquisa e descoberta significativamente melhores do que as infraestruturas tecnológicas tradicionais, o MCP é a solução ideal como base para experiências que priorizam o conteúdo, que aproveitam dados estruturados e dependem de um raciocínio que é melhor realizado fora do próprio “ LLM ”.
A atualidade dos dados é fundamental nesse contexto. Arquivos de documentos estáticos podem responder a uma consulta do usuário sobre o histórico de como um determinado filme ou série de TV foi desenvolvido, mas não ajudam os usuários a identificar quando ou onde essa série ou filme será transmitido. LLM Os dados de treinamento são fixos no tempo; portanto, o “grounding” fornece aos LLMs não apenas dados corretos, mas também dados oportunos e atualizados, o que permite que os LLMs acessem o mundo real além de seu modelo de “conhecimento restrito”.
Mas a disponibilidade de programas é apenas a ponta do iceberg. O MCP inaugura uma nova era de experiências de entretenimento graças à sua capacidade de criar experiências extremamente ricas e personalizadas. Veja um exemplo:
- Uma operadora de TV a cabo deseja criar uma seleção diária de filmes recomendados com base na localização do usuário e nas condições meteorológicas do momento.
- O provedor conecta seu endereço de base LLM a dois servidores MCP: um que retorna as informações meteorológicas para o local e outro que retorna o conteúdo ID para uma combinação de filme e ano.
- Quando o usuário faz login pela primeira vez naquele dia, o provedor solicita ao LLM que retorne os 10 filmes mais populares com base nas condições climáticas do endereço IP específico.
- O “ LLM ” utiliza o MCP meteorológico para determinar as condições climáticas atuais
- O “ LLM ” então seleciona uma lista de filmes que retratam essas condições climáticas, com base exclusivamente no conhecimento contido no modelo de base.
- O ` LLM ` consulta um provedor de metadados de entretenimento que retorna o conteúdo ID para cada filme recomendado.
- As recomendações de filmes são enviadas ao provedor de TV a cabo e exibidas ao usuário.
O uso de LLMs será transformador para o público, mas, sem contextualização, esses modelos ficam restritos a respostas não verificadas e limitadas ao momento em que foram geradas. Os LLMs contextualizados permitirão que plataformas e serviços superem as limitações das infraestruturas tradicionais de busca, ao mesmo tempo em que abrirão as portas para uma ampla gama de consultas sofisticadas que gerarão respostas mais atuais e relevantes.
Para saber mais, baixe nosso white paper do MCP Server.
Nota
- Os LLMs são um tipo de IA generativa que cria conteúdo com base em padrões aprendidos.
2026 State of Play
O streaming tornou-se abrangente em suas ofertas, o que amplia os crescentes desafios relacionados à descoberta de conteúdo.
A próxima vantagem da CTV programática está no conteúdo
A inteligência de conteúdo incorpora o que aparece na tela às decisões atuais de compra de anúncios — e poderá fornecer aos sistemas automatizados informações mais completas para a otimização no futuro.
O custo da fragmentação: os desafios da descoberta estão levando os fãs de esportes a buscar os melhores momentos
Para os fãs de esportes, a dificuldade em encontrar conteúdo é um obstáculo maior do que o custo da assinatura.