أصبح العالم أكثر تفاعلاً من الناحية الحوارية، وتساعد تقنية الذكاء الاصطناعي من الجيل الجديد (GenAI) الناس على التعامل مع عالم يزداد تعقيدًا. وفي عالم الترفيه، يستخدم مشاهدو التلفزيون البحث الصوتي للتغلب على الازدحام الذي يشهده المشهد المتنامي لمحتوى الفيديو، والذي يستمر في التشتت عبر القنوات والخدمات المختلفة.
على الرغم من انتشار وظائف الصوت عبر الأجهزة، فإن فائدة هذه التكنولوجيا تعتمد على البيانات — أي المعلومات الواقعية والآنية التي يستخدمها نظام« LLM1» للتحقق من صحة الردود التي يقدمها على استفسارات المستخدمين، وتزويدها بالمعلومات اللازمة، وتصحيحها. وفي مجال البث المباشر، يُعد هذا الأمر بالغ الأهمية بشكل خاص بالنسبة للمحتوى المكون من حلقات.
لا يقتصر الأمر على أن كمية المحتوى التلفزيوني تفوق عدد الأفلام المتاحة بكثير فحسب، بل إن الجمهور يبحث عن حلقات المسلسلات بطريقة تختلف عن طريقة بحثه عن الأفلام. نادرًا ما يعرف المشاهدون الموسم أو الحلقة المحددة التي يرغبون في مشاهدتها، خاصةً في الحالات التي تكون فيها المسلسلات قد استمرت لفترة طويلة مثل المسلسلات الشهيرة مثل NCIS وGrey’s Anatomy وThe Simpsons. لذا، عند البحث، يستخدمون استفسارات سياقية مثل «أرني حلقات عيد الميلاد من مسلسل The Office»و«ما هي حلقات مسلسل Friends التي يظهر فيها بروس ويليس كضيف شرف؟»
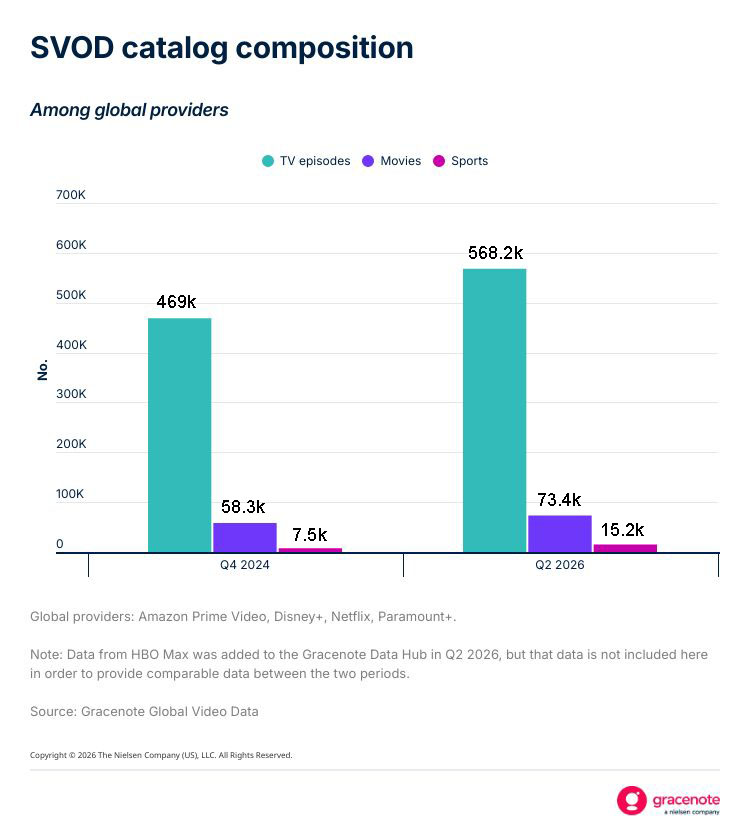
في هذه الحالات، عادةً ما تكون إجابات موقع « LLM » غير صحيحة. ويرجع ذلك إلى أنها تستند في إجاباتها إلى الاحتمالات بناءً على الموسم ورقم الحلقة. وبالنسبة لمقدمي الخدمة، فإن تجربة المستخدم السيئة المرتبطة بالإجابات غير الصحيحة ستزيد من الإحباط الناجم عن تزايد تجزئة المحتوى. ويلعب المحتوى المسلسل دورًا كبيرًا في ازدحام المحتوى، حيث تشكل حلقات المسلسلات التلفزيونية 85% من المحتوى الذي توزعه شركات خدمة الفيديو حسب الطلب (SVOD) العالمية الست التي تم تتبعها في Gracenote Data Hub.
مع تزايد حجم مكتبات الفيديو، ستصبح تقنية الذكاء الاصطناعي من الجيل الجديد (GenAI) أكثر فائدة للمشاهدين الباحثين عن محتوى لمشاهدته. فعلى سبيل المثال، في غضون عام ونصف فقط، زاد عدد حلقات المسلسلات التلفزيونية المتاحة للجمهور بأكثر من 21%.
من خلال تقديم ميزات مثل البحث التفاعلي، والصور المخصصة للبرامج، والتوصيات المخصصة، وأبرز أحداث المباريات الرياضية في الوقت الفعلي، ستُحدث تقنية الذكاء الاصطناعي العام (GenAI) تحولاً جذرياً في طريقة تفاعل المشاهدين مع المحتوى المرئي.
ولتوفير هذه الإمكانات — وتقديمها بطرق ملائمة ومخصصة — تحتاج نماذج اللغة الكبيرة (LLMs) التي تدعم عمليات البحث والاكتشاف إلى الوصول إلى بيانات ترفيهية دقيقة وشاملة. وينطبق هذا بشكل خاص على 50% من الأمريكيين الذين أفادوا بأنهم سيفكرون في إلغاء اشتراكهم في خدمة ما إذا لم توفر محتوى يثيراهتمامهم2.
يُعد الاتصال بالبيانات المُثبتة في الوقت الفعلي أمرًا بالغ الأهمية، حيث إن نماذج اللغة الكبيرة (LLMs) التي يتم نشرها للاستخدام المؤسسي لا تستند إلى أي مصادر معلومات خارجية. وعلى عكس روبوتات الدردشة الشهيرة (مثل ChatGPT وGemini)، فإنها لا تعرف سوى ما توفره بيانات تدريبها. وفي هذه الحالة، غالبًا ما تقع المعلومات المتعلقة بالبرامج الجديدة خارج نطاق بيانات تدريب نظام التوصية التلقائي ( LLM)، مما يحرمها من القدرة على مساعدة المشاهدين في العثور على ما يبحثون عنه. فمثلاً، فيلم «Rooster» الكوميدي الذي يقوده ستيف كاريل هو فيلم حديث جدًّا بحيث لا يمكن لنظام LLM الذي تم إصداره في عام 2025 أن يمتلك أي معلومات عنه.
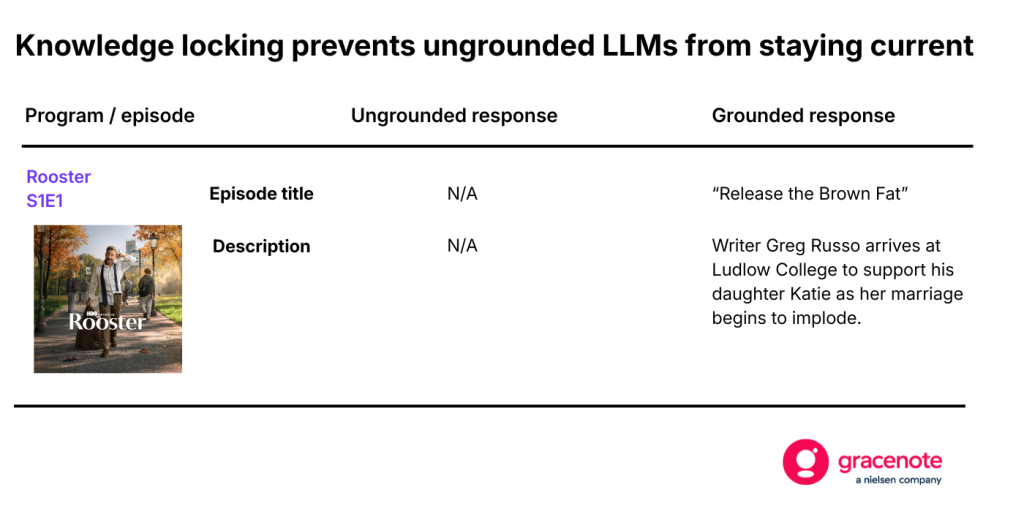
ردود « LLM » غير المبررة وتجربة المشاهد
كما هو موضح بالتفصيل في تقريرنا الأخير «ثغرات في الذكاء الاصطناعي»، تواجه نماذج اللغة الكبيرة (LLMs) غير المدعمة ببيانات صعوبة في تقديم إجابات دقيقة عند سؤالها عن السمات الأساسية في المسلسلات التلفزيونية والأفلام الشهيرة. وعندما يتعلق الأمر بالمحتوى المكون من حلقات، فإن هذا القصور يكون أكثر وضوحًا بكثير. ويرجع ذلك إلى أن سمات البيانات الوصفية تكون أكثر تميزًا على مستوى الحلقة مقارنةً بمستوى عنوان البرنامج.
إن التخمين الدلالي، والاحتمالات التنبؤية، ونقص قدرات الفهرسة، كلها عوامل تسهم في زيادة احتمالية كبيرة بأن يظهر موقع « LLM » غير الموثوق به نتائج خاطئة عندما لا يتوفر لديه سوى عنوان البرنامج ورقم الموسم ورقم الحلقة. والأهم من ذلك، أن المشاهدين نادرًا ما يبحثون عن حلقة باستخدام عنوانها.
لفهم أهمية الربط بالمحتوى في عمليات البحث والاكتشاف على مستوى الحلقات بشكل أفضل، قمنا مؤخرًا بتقييم جودة الإجابات غير المرتبطة بالمحتوى التي قدمها موقع « LLM » على أسئلة أساسية حول حلقات تلفزيونية محددة. ورغم أن المستخدمين لا يجرون عمليات البحث بهذه الطريقة، فقد استخدمنا أرقام المواسم والحلقات في استفساراتنا لتقييم دقة البيانات الوصفية المرتبطة بها. وشملت الدراسة 100 حلقة شهيرة من 13 دولة (1,300 حلقة إجمالًا).
بشكل عام، كانت دقة المعلومات الواردة في الردود المتعلقة بالحلقات أقل بكثير مما كانت عليه بالنسبة للمسلسلات التلفزيونية والأفلام. فعلى سبيل المثال، من بين أفضل 100 حلقة في الولايات المتحدة، لم تتجاوزنسبة دقة أوصاف البرامج، في المتوسط، 27٪²، مقارنة بمتوسط بلغ 69٪ لأوصاف أفضل 100 مسلسل تلفزيوني وأفضل 100 فيلم.
لم تكن الدقة هي السمة الوحيدة التي واجهت موقع « LLM » غير الموثوق بها صعوبات في تناولها عبر 1,300 حلقة (100 حلقة لكل بلد) شملتها الدراسة. فقد كان توفر المعلومات مشكلة أكبر، حيث لم يكن لدى الموقع أي معلومات (العنوان، الوصف، الممثلون، النوع) عن 604 حلقات (46.5% من الإجمالي). وكان هذا أكثر وضوحًا في السويد، حيث لم تُقدَّم أي معلومات عن 73 حلقة من أصل 100 حلقة. وفي الولايات المتحدة، لم يقدم موقع « LLM » غير المرتبط بأي مصدر معلومات عن 31 حلقة.
الذي يحتوي على قصة خاطئة
وعندما لم تكن خدمة « LLM » غير المرتبطة بأي أساس تُرجع استجابات فارغة، كانت تقدم في كثير من الأحيان أوصافًا غير صحيحة للحلقات — وهو نتيجة ثانوية للتخمين الدلالي، والاحتمالات التنبؤية، ونقص الفهرسة. وفي حين أنه من غير المرجح أن يبحث المشاهدون عن حلقة ما باستخدام رقم المسلسل ورقم الحلقة فقط، فإن خدمات البث تستخدم هذه السمات لتحويل عناوين الحلقات الناتجة إلى روابط عميقة أو سجل مرتبط بها في قاعدة بياناتها الضخمة. وهنا، يُعد تنسيق البيانات في الخلفية وفهرستها أمرًا بالغ الأهمية لضمان قدرة الخدمة على إرجاع المحتوى الصحيح بدقة لكل مشاهد على حدة.
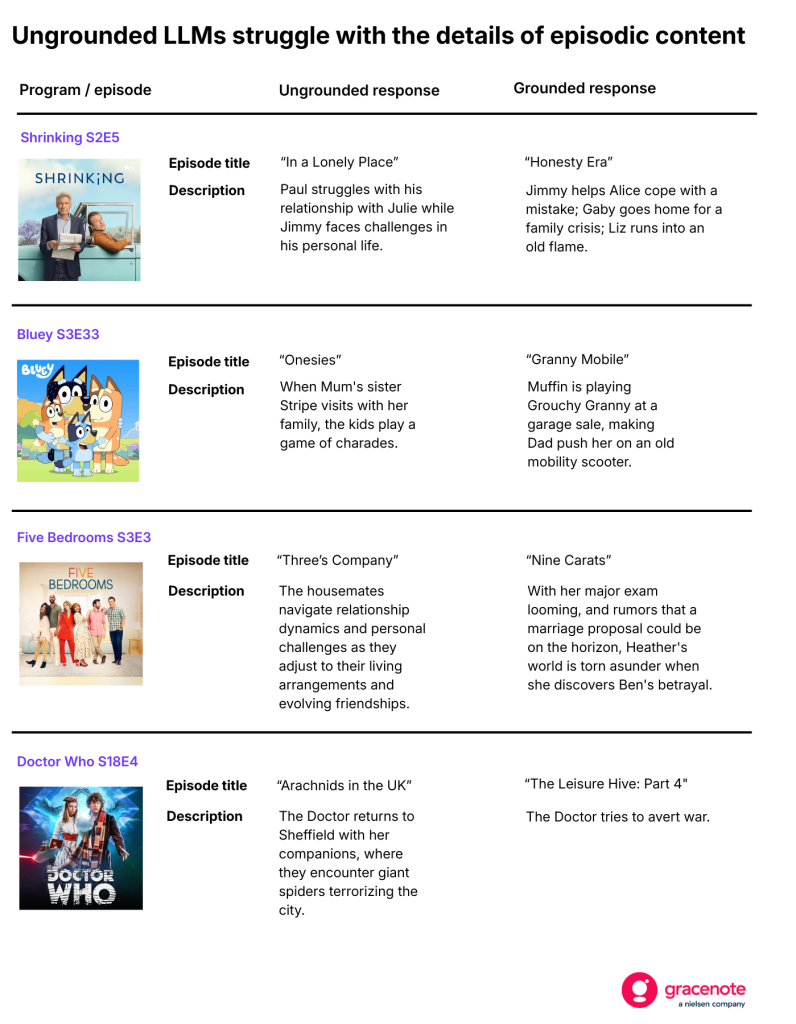
ونظرًا لوجود رقم المسلسل ورقم الحلقة فقط في كل استعلام، غالبًا ما كانت خدمة « LLM » غير المحددة المراجع تقدم أوصافًا تحدد تفاصيل حلقات مختلفة تمامًا عن تلك التي تم الاستفسار عنها. وفي الأمثلة أدناه، فإن العناوين والأوصاف التي قدمتها خدمة « LLM » غير المحددة المراجع غير صحيحة.
يُعد التوصيل بالأرض أمرًا بالغ الأهمية لتجارب المحتوى من الجيل التالي
إن الطريقة التي يبحث بها المستهلكون عن المعلومات والأدوات التي يستخدمونها آخذة في التغير. ويُعد استخدام الذكاء الاصطناعي العام (GenAI) ركيزة أساسية بين جيل الرقمية، كما أن انتشار استخدامه آخذ في التوسع بسرعة.
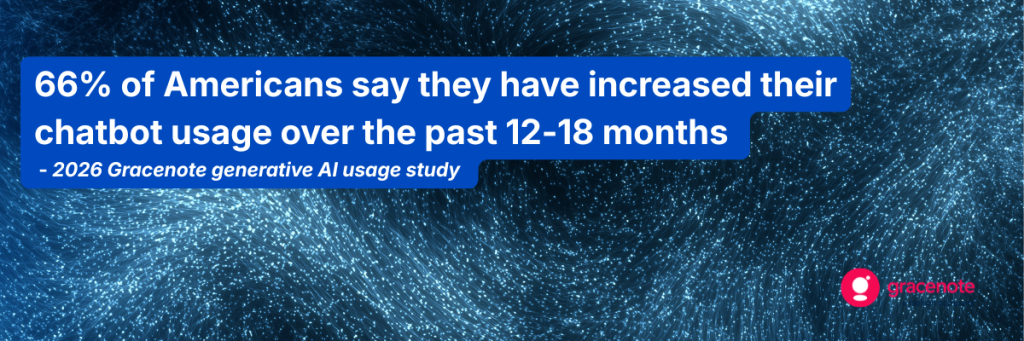
أصبح مجال المحتوى اليوم واسعًا للغاية بحيث يتعذر تصفحه باستخدام وظائف البحث التقليدية — حتى داخل المنصات والخدمات الفردية. ويُعد استخدام الذكاء الاصطناعي من الجيل الجديد (GenAI) في البحث عن المحتوى واكتشافه تحولًا جذريًّا في تجربة المستخدم، وهو ما ينطوي على إمكانية الحد بشكل كبير من المشاعر السلبية لدى المشاهدين مع تزايد ازدحام المحتوى.
ولكن عند سؤاله عن الحلقة S02E06 من مسلسل «Stranger Things»، جاء رد « LLM» غير الدقيق مختلطًا بمعلومات من عدة حلقات مختلفة. وهنا، سيصل المشاهد في النهاية إلى عدم الثقة في الخدمة، وهو أمر شائع بالفعل بين مستخدمي روبوتات الدردشة حاليًا: حيث يقول 75% منهم إنهم يتحققون من صحة النتائج التي تقدمها روبوتات الدردشة التي تعمل بالذكاء الاصطناعي خوفًا من أن تكونغير صحيحة3.
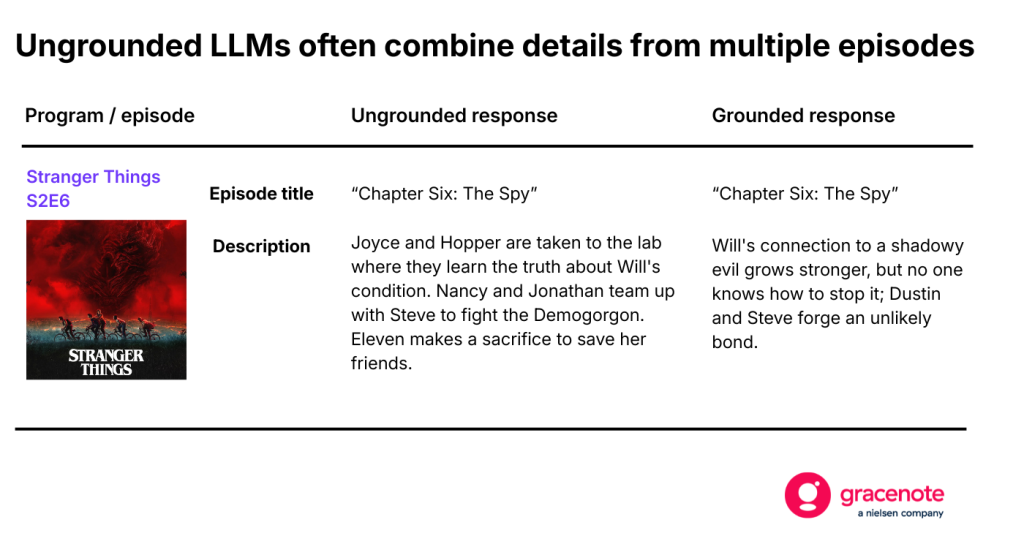
والنتيجة النهائية في هذا السيناريو هي تجربة مستخدم سيئة — وهي تجربة قد تدفع المشاهد إلى البحث في مكان آخر عن شيء يشاهده.
للحصول على رؤى إضافية حول استخدام نماذج اللغة الكبيرة (LLMs) غير المربوطة ببيانات محددة في تجارب البحث عن المحتوى واكتشافه، قم بتنزيل تقرير "ثغرات في الذكاء الاصطناعي".
الملاحظات
- تعد نماذج اللغة الكبيرة (LLMs) نوعًا من الذكاء الاصطناعي التوليدي الذي يتم تدريبه على كميات هائلة من البيانات لفهم اللغة وتوليدها بطريقة تشبه اللغة البشرية.
- عند مقارنتها ببيانات التثبيت.
- Gracenote دراسة استخدام GenAI لعام 2026
لماذا تُعد تجربة المستخدم المقياس النهائي للرضا
في ظل تزايد تجزئة محتوى الفيديو، لا يجد المشاهدون ما يبحثون عنه. ويمكن أن تساعد تجربة المستخدم المحسّنة في حل هذه المشكلة.
2026 State of Play
أصبحت خدمات البث المباشر شاملة في عروضها، مما زاد من صعوبة اكتشاف المحتوى.
ثمن التجزئة: التحديات التي تواجه اكتشاف المحتوى تدفع عشاق الرياضة إلى متابعة اللقطات البارزة
يُعد «ديسكفري» عقبة أكبر أمام عشاق الرياضة مقارنة بتكلفة الاشتراك.